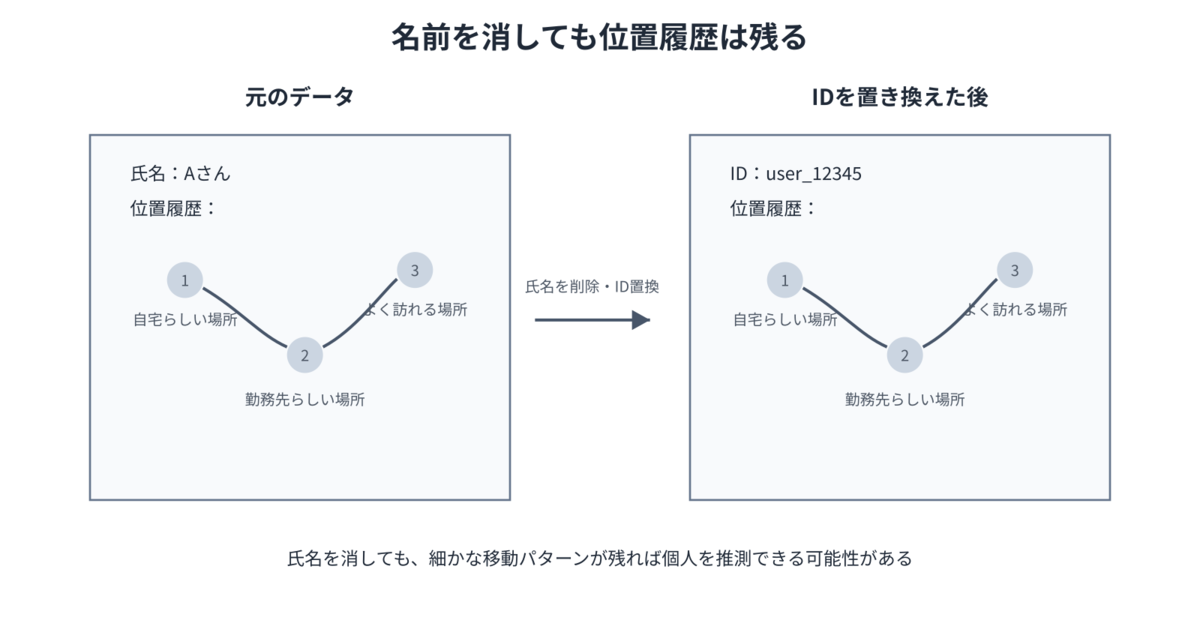
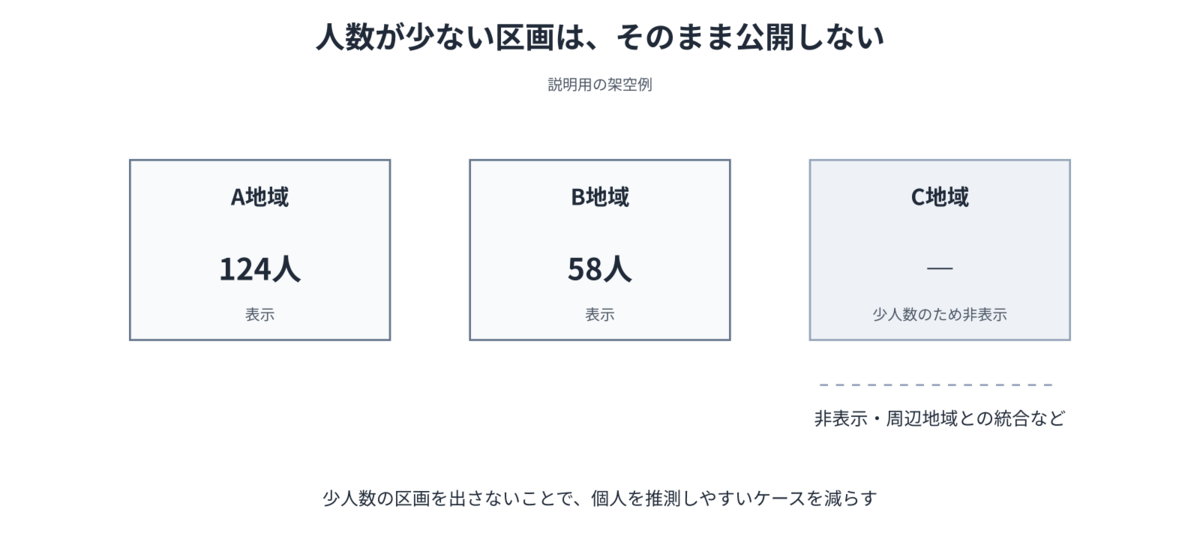
自分用の備忘メモ。「人流データ」という言葉はよく使われますが、その中身は必ずしも同じではありません。GPSから取得した位置情報を指して「人流データ」と呼ぶこともあれば、駅や地域の滞在人口、店舗への来訪者数、地域間の移動を表すOD(Origin-Destination:出発地・到着地)データなども、同じように人流データと呼ばれます。
以前、日本で使える人流データまとめ(無料/研究申請/商用) という記事で、人流データをどこから入手できるのかを整理しました。また、日本で使えるロケーションインテリジェンス製品・サービスを整理してみた【2026年版】 では、携帯電話ネットワーク、GPS、アプリSDKなど、人流データを取得する方法の違いにも触れています。
今回は「どこから入手するか」「どのように取得するか」ではなく、人流データとして実際にはどのような種類のデータが存在するのかを整理してみます。
この違いを考えるうえで特に重要なのが、「GPSデータ」と「ODデータ」のような言葉を同じ分類軸で捉えないことです。GPSは位置情報をどう取得したかを表す言葉ですが、ODは取得した位置情報などを加工・集計してどのような形のデータにしたかを表しています。人流データを理解するには、まずこの2つを切り分けて考える必要があります。
人流データには少なくとも3つの軸がある
人流データを整理するときには、少なくとも3つの異なる軸があると考えると分かりやすくなります。
1つ目は取得方式です。携帯電話ネットワーク、GPS、アプリSDK、Wi-Fi、ビーコンなど、「現実世界にいる人の位置や行動をどのような仕組みで観測したか」という違いです。
2つ目が、今回の中心テーマとなるデータ種別です。取得した位置情報を位置点として扱うのか、軌跡・移動区間にするのか、滞在や来訪というイベントに変換するのか、あるいは地域別人口やODとして集計するのか、という違いがあります。
3つ目が人数の表し方です。観測できたサンプル数をそのまま扱う場合もあれば、そのサンプルから母集団全体の人数を推計する場合もあります。同じ「この地域には1万人いる」という数字でも、観測されたサンプル数なのか、母集団へ拡大推計した人数なのかでは意味が異なります。
この記事では、このうち特に2つ目の「データ種別」を中心に整理し、最後に3つ目の「拡大推計」についても触れます。
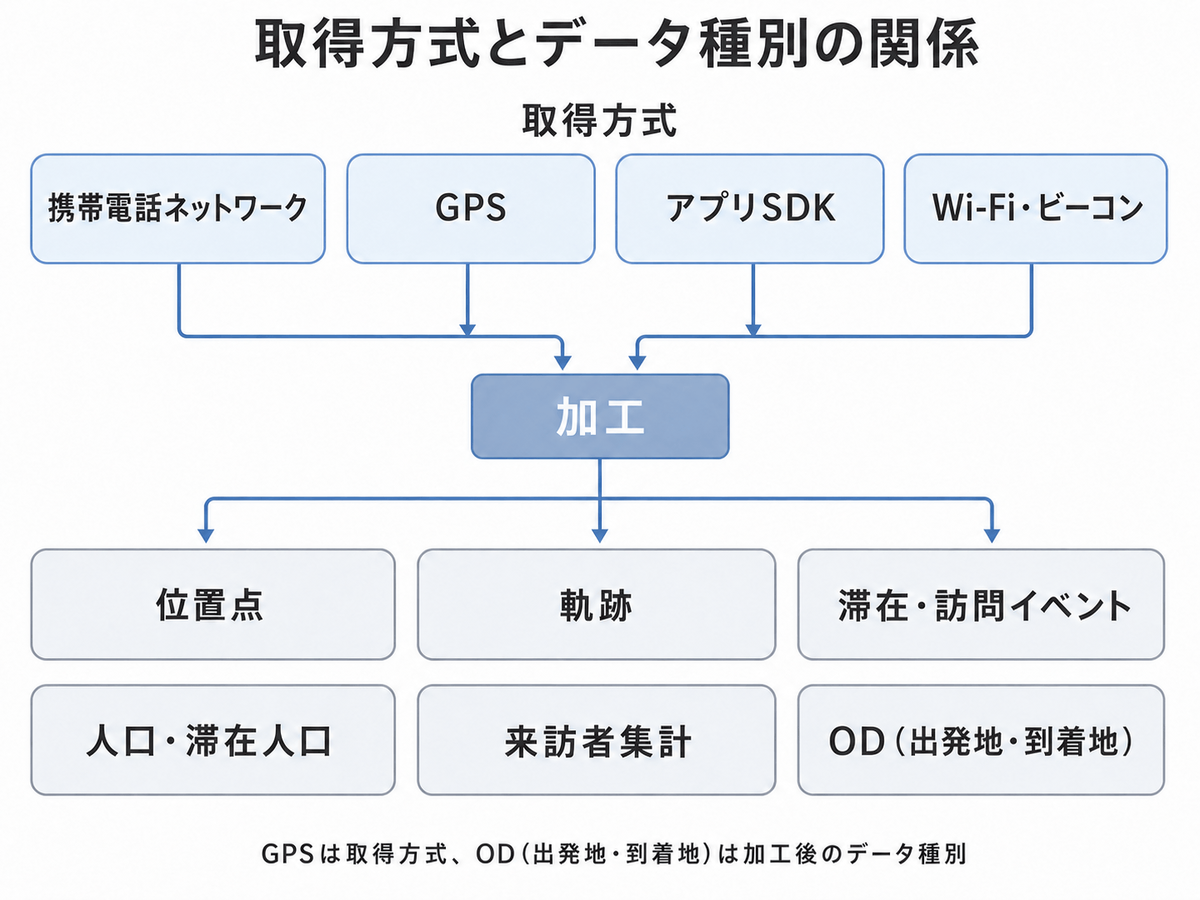 図1:人流データでは、「どう取得したか」と「どのようなデータとして表現・加工・集計したか」を分けて考える必要がある。
たとえばGPSから取得した位置情報をもとに、移動軌跡を作ることもできますし、店舗への来訪を判定したり、地域間のODデータへ集計したりすることもできます。逆にODデータはGPSだけから作られるとは限らず、携帯電話ネットワークなど別の取得方式をもとに作られる場合もあります。
つまり、「GPSか携帯電話ネットワークか」という話と、「ODか滞在人口か」という話は別の軸なのです。
「個票」と「集計データ」を分けて考える
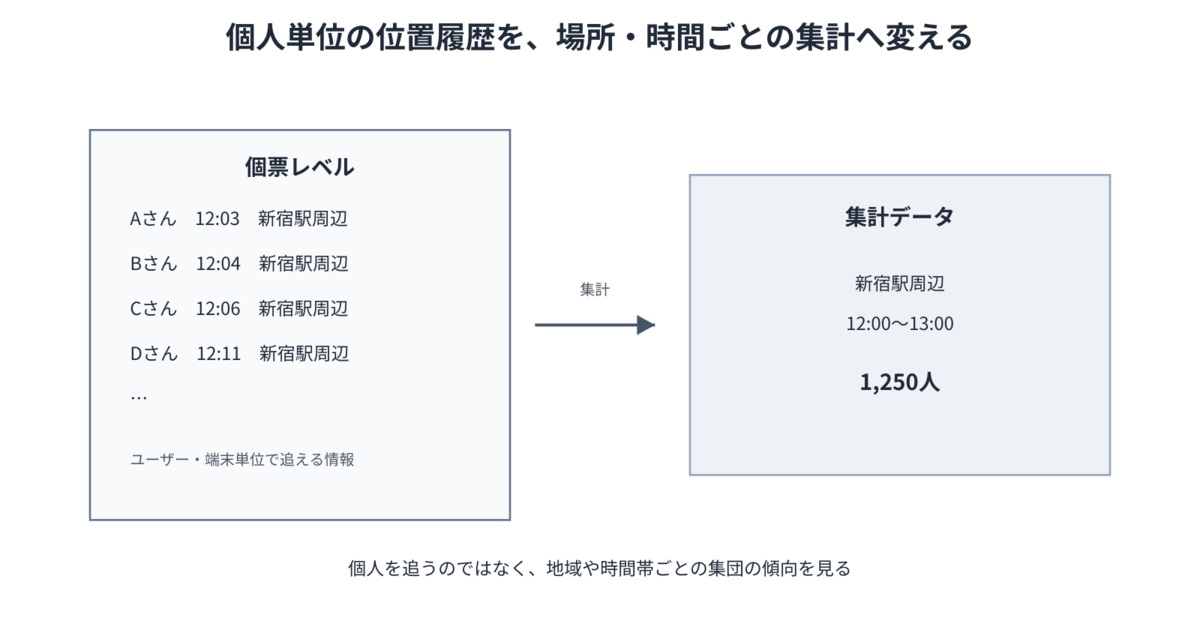
データ種別をさらに整理すると、大きく「個票レベルのデータ」と「集計データ」に分けることができます。
個票レベルとは、ユーザーや端末を単位として位置や行動を記録したデータです。ある時刻の位置を表す「位置点」、それらを時系列に扱った「軌跡・移動区間」、そこから判定した「滞在・訪問イベント」などが該当します。
一方、集計データは、こうした個票レベルの情報を地域や施設、時間帯などの単位にまとめたものです。「この125mメッシュには何人いたか」「この店舗には1カ月間で何人が来訪したか」「新宿から渋谷へ何人移動したか」といったデータはこちらに当たります。
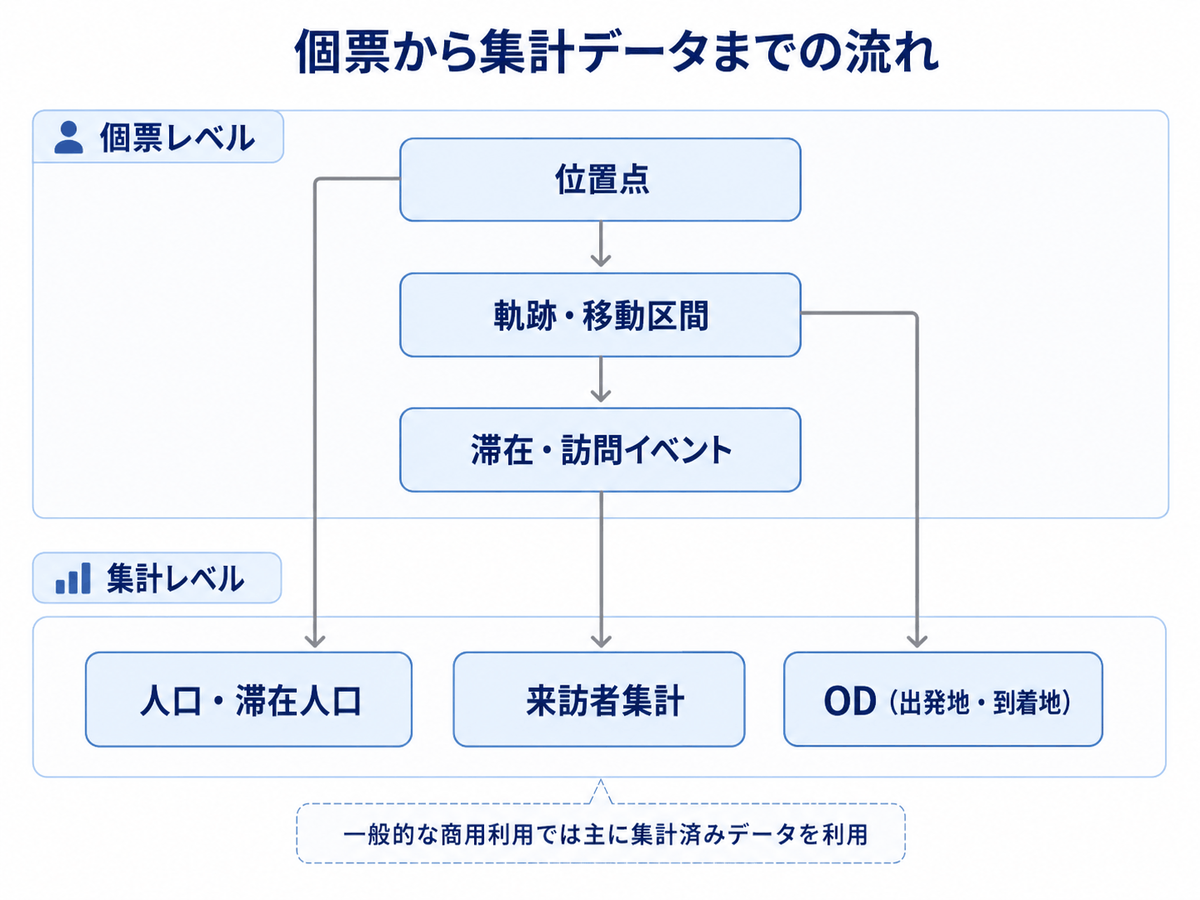 図2:個票レベルでは位置点から軌跡・移動区間、滞在・訪問イベントなどが作られる。そこから用途に応じて、人口・滞在人口、来訪者集計、OD(出発地・到着地)などの集計データへ変換される。
この区別は実務上かなり重要です。人流データの仕組みを理解するためには、位置点や軌跡といった個票レベルの存在を知っておく必要があります。一方、一般的な商用人流サービスで企業ユーザーに提供されるのは、ユーザー・端末単位の個票そのものではなく、加工・集計されたデータであることが多いです。
そのため、人流データを利用する立場では、「どのような位置情報を取得しているのか」だけでなく、その位置情報がどの段階まで加工され、どの単位に集計されて提供されているのかを見る必要があります。
(1)位置点データ
人流データの最も基本的な形が、ある時刻における位置を記録した「位置点」です。概念的には、次のようなデータをイメージすると分かりやすいでしょう。
user_id | timestamp           | latitude | longitude
A001    | 2026-09-03 12:01:05 | 35.68950 | 139.69171
A001    | 2026-09-03 12:03:18 | 35.68962 | 139.69210
A002    | 2026-09-03 12:03:44 | 35.65810 | 139.70120
この段階で分かるのは、「ある端末が、ある時刻に、ある位置で観測された」ということです。その人が歩いていたのか、電車に乗っていたのか、店に滞在していたのか、といった意味までは位置点だけでは直接分かりません。
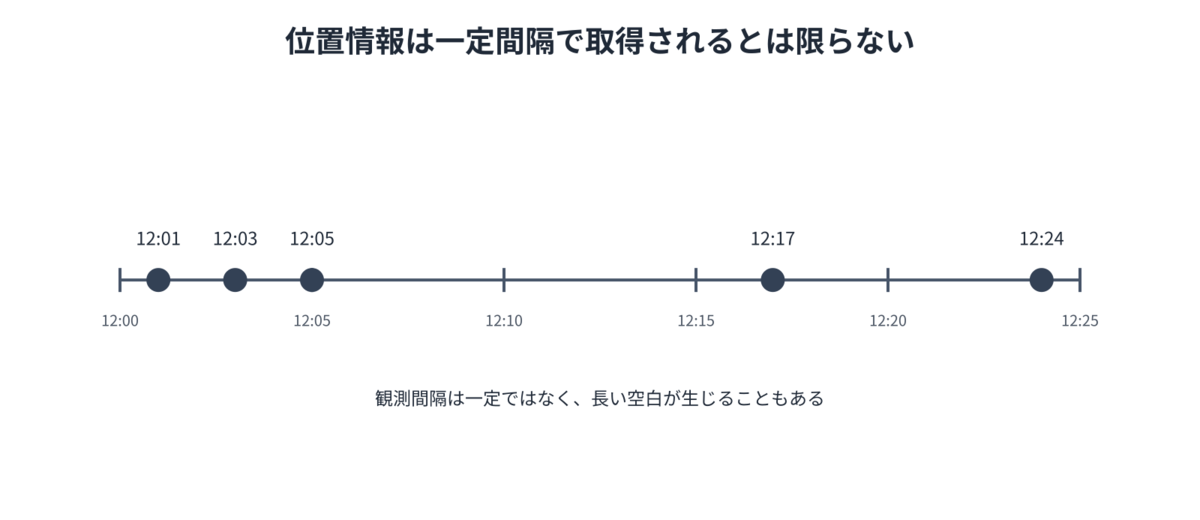
また、実際の位置情報には観測間隔のばらつきや位置誤差があります。そのため、位置点は人流分析の出発点ではありますが、通常は目的に応じてさらに加工して利用します。
なお、ここで示しているのはデータ構造を理解するための概念例です。実際のデータでは、識別子の扱いや前処理、プライバシー保護などがサービスによって異なります。
(2)軌跡・移動区間データ
同じユーザーの位置点を時間順に扱うことで、どのように移動したのかを表す「軌跡」や「移動区間」を作ることができます。
位置点が「ある瞬間にどこにいたか」を表すのに対し、軌跡・移動区間には「どこからどこへ動いたか」という時間的な連続性が加わります。そのため、移動経路や回遊、移動距離などを分析する際には、位置点よりも扱いやすい形式になります。
ただし、観測された点を単純に線で結べば正確な移動経路になるわけではありません。たとえば10分間位置情報が取得できなかった場合、その間にどの道を通ったかは分かりませんし、GPSなどの位置情報自体にも誤差があります。
したがって、軌跡・移動区間は単なる「点の集合」ではなく、位置点を時間順序も含めて移動として解釈できる形へ加工したデータと考えるのがよさそうです。
(3)滞在・訪問イベント
位置点や軌跡からさらに意味を抽出すると、「ある場所に滞在した」「ある施設を訪れた」というイベントとして表現できます。
たとえば概念的には、次のようなデータです。
user_id | place_id | arrival_time        | departure_time      | stay_minutes
A001    | SHOP123  | 2026-09-03 12:05:10 | 2026-09-03 12:27:30 | 22
この段階になると、単なる緯度・経度ではなく、「SHOP123という場所に22分滞在した」という意味が付加されています。
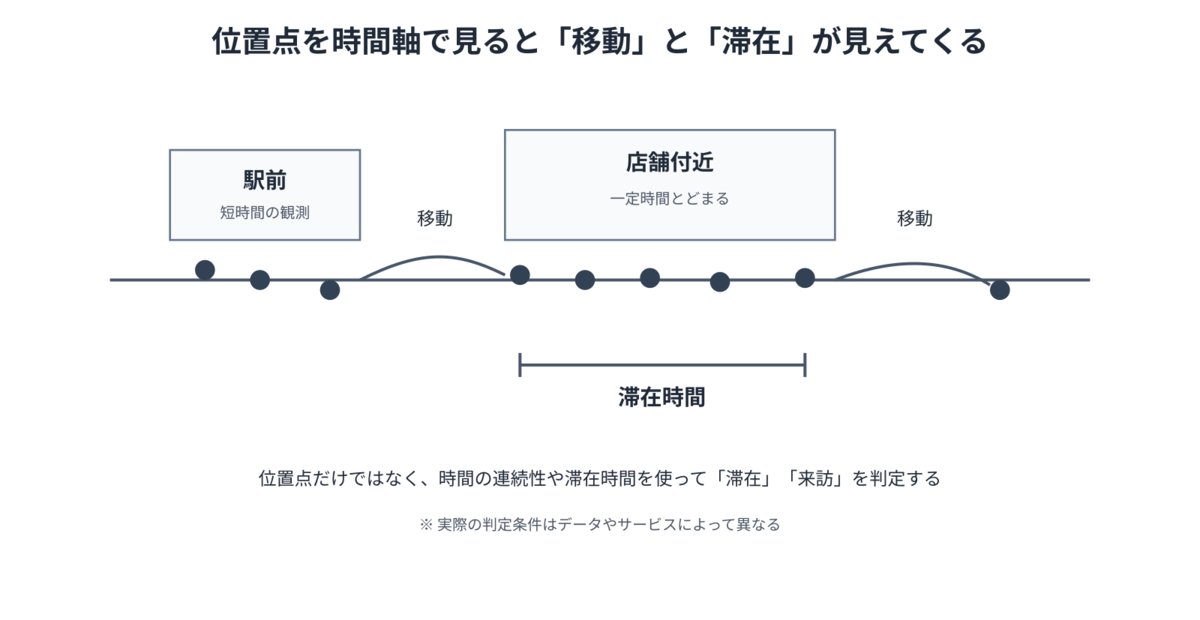
ここで注意したいのは、店舗付近で位置情報が観測されたことと、その店舗へ「来訪した」と判定することは同じではないという点です。店の前を通過しただけかもしれませんし、位置誤差によって実際とは少し違う場所に記録されている可能性もあります。
そのため実際には、対象施設との距離や滞在時間、施設の形状、位置精度などを考慮して「滞在」や「来訪」を判定する必要があります。滞在・訪問イベントは位置情報そのものではなく、一定のルールによって位置情報に意味を付けた加工データということになります。
ここから先は「集計データ」
ここまで挙げた位置点、軌跡・移動区間、滞在・訪問イベントは、基本的にはユーザーや端末を単位として考えるデータでした。これらを複数のユーザーについて地域や施設などの単位にまとめると、企業や研究者が一般的に「人流データ」として利用することの多い集計データになります。
代表的なのが、「人口・滞在人口」「来訪者集計」「OD(出発地・到着地)」です。ただし図2にも示したように、これらがすべて「位置点→軌跡→滞在・訪問イベント」という同じ一本道を経て作られるわけではありません。人口・滞在人口は位置情報から地域単位に集計できますし、ODは軌跡や移動区間から作ることができます。どの加工工程を経るかは、作りたいデータによって異なります。
(4)人口・滞在人口データ
人口・滞在人口データは、ある空間に、ある時間帯に、何人いたのかを集計したものです。概念的には、次のような形になります。
time             | area_id    | people
2026-09-03 12:00 | mesh_125_1 | 3250
2026-09-03 13:00 | mesh_125_1 | 3012
このデータでは、個々の人がどのような経路を通ってきたのかではなく、「この地域に何人いるのか」が主な関心になります。そのため、都市の混雑状況、商圏、観光地の人出、イベント前後の人口変化などを見るのに向いています。
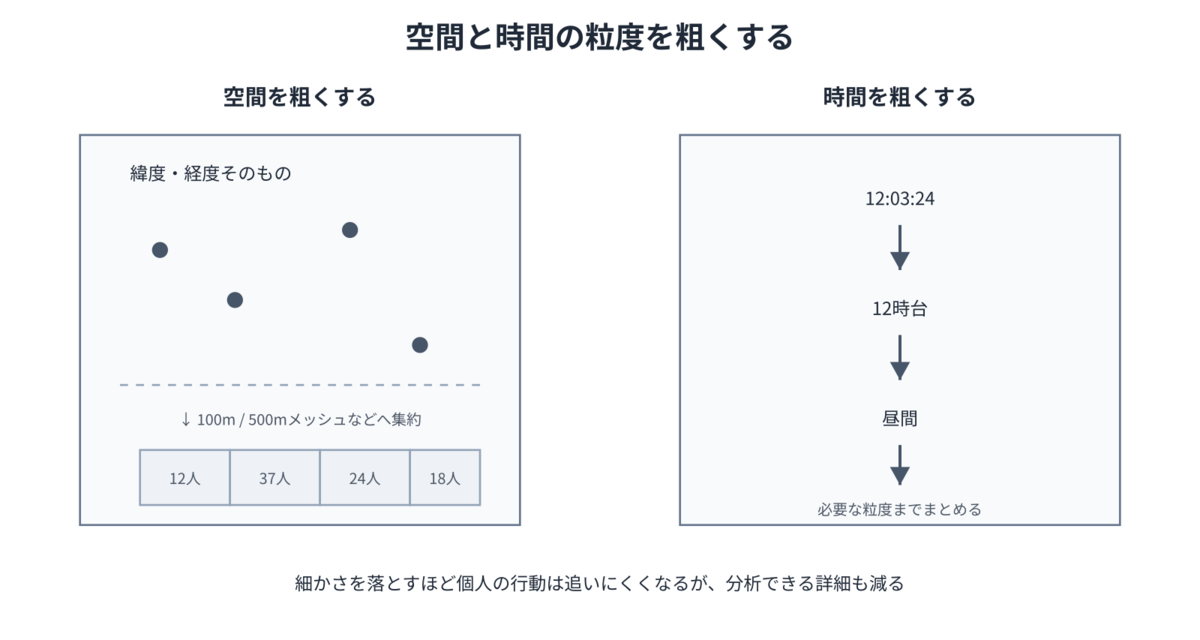
集計単位には、市区町村のような行政区域だけでなく、500mメッシュや125mメッシュなどの格子、独自のポリゴンなど、さまざまなものがあります。最近では、六角形セルによって地球上の位置を扱うH3のような地理空間インデックスを分析単位として使うこともできます。
この「位置情報をどの空間単位にまとめるか」という問題については、H3とは? 地球を六角形で区切る地理空間インデックスを調べてみた でも整理しました。同じ位置情報でも、どの大きさ・形の空間へ集計するかによって見える特徴は変わります。
(5)来訪者集計データ
人口・滞在人口が「地域」を単位として集計するのに対し、「店舗」「駅」「商業施設」など特定のPOIを単位として来訪イベントを集計したものが、来訪者集計データです。
たとえば、次のような形を考えられます。
poi_id  | period  | unique_visitors | total_visits
SHOP123 | 2026-09 | 18240           | 26310
ここでは、「地域に何人いたか」ではなく、「その施設を何人が訪れたか」に焦点が移ります。さらに、居住地域や来訪頻度、曜日・時間帯などの情報と組み合わせれば、商圏や顧客行動をより詳しく分析できます。
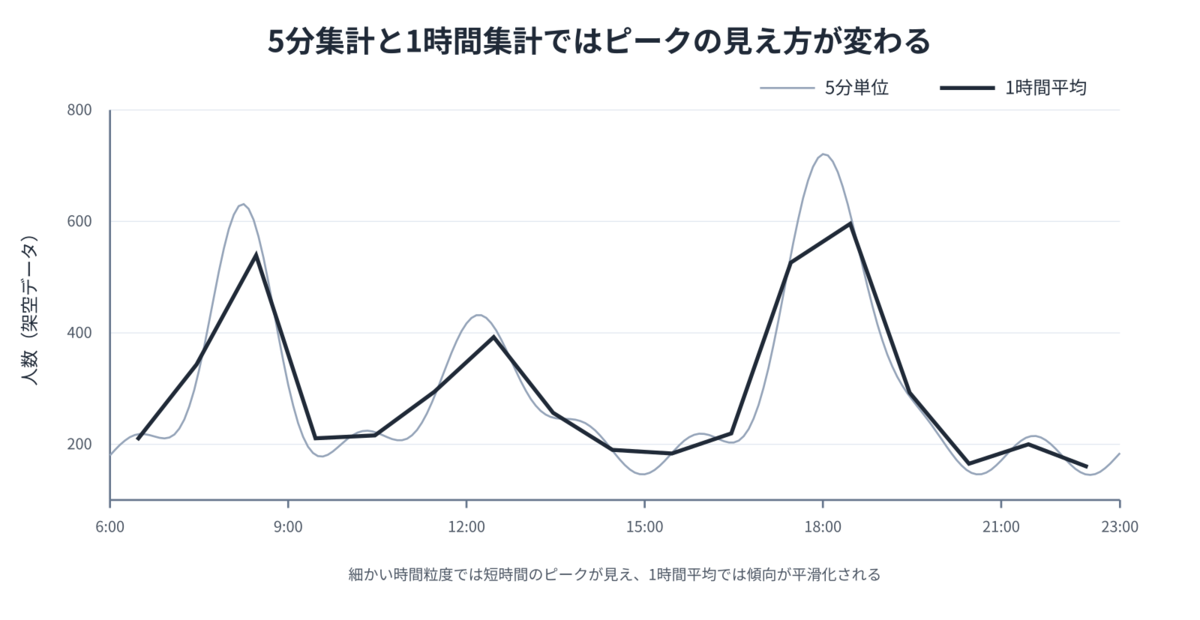
なお、unique_visitors のようなユニーク来訪者数と、total_visits のような延べ来訪回数では意味が異なります。同じ人が1カ月に何度も訪れれば、ユニーク人数は1人でも来訪回数は複数になります。このような時間方向の集計方法によっても人流データの意味は変わります。
(6)OD(出発地・到着地)データ
ODは「Origin-Destination」の略で、出発地と到着地の組み合わせごとに、人やトリップなどの移動量を集計したデータです。
たとえば人数を集計する場合は、次のような形式になります。
origin | destination | people
新宿区 | 渋谷区      | 1250
新宿区 | 豊島区      | 870
個票レベルで「A地点からB地点へ移動した」という情報は移動区間やトリップとして扱えますが、それらを地域単位などでまとめ、「新宿区から渋谷区へ何人移動したか」といった形にしたものがODデータです。
そのため、ODはそれ自体がすでに集計された人の流れを表しています。なお、「出発地」「到着地」が何を意味するかはデータによって異なり、実際のトリップの起終点の場合もあれば、居住地と来訪地などを組み合わせた集計の場合もあります。ODデータを利用するときには、OriginとDestinationがどのように定義されているかを確認する必要があります。
ODデータは、鉄道や道路などの交通分析、都市間・地域間の移動、観光客の周遊、居住地域から商業地域への流れなど、単純な人口分布だけでは分からない「どこからどこへ」という方向性を見るのに役立ちます。
同じ「人数」でも、観測値と推計値は違う
ここまで説明してきたのは主にデータの「形」の違いでした。しかし、人流データを扱うときには、これとは別にもう一つ重要な軸があります。それが、表示されている人数が観測サンプルなのか、母集団へ拡大推計した値なのかという違いです。
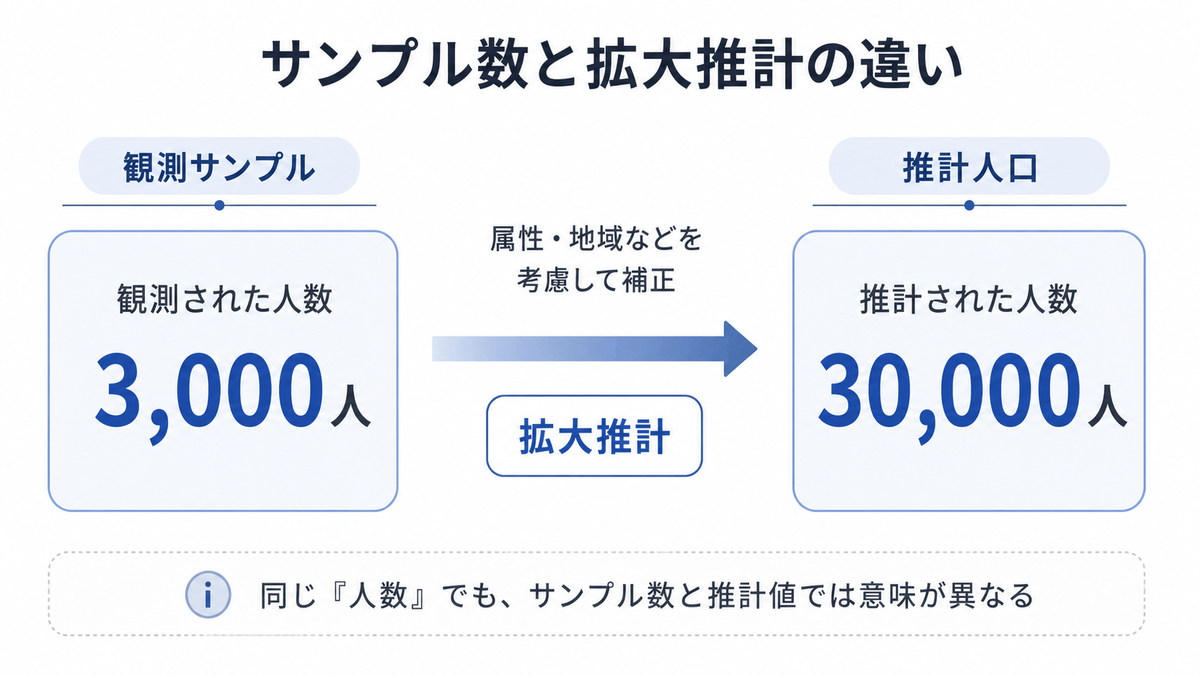 図3:同じ「人数」でも、実際に観測されたサンプル数と、母集団へ拡大推計した人数では意味が異なる。図中の数値は仕組みを説明するための架空例。
たとえば、ある地域について3000人分の位置情報を観測できたとします。これはあくまで、そのデータソースで観測できた3000人であり、現実世界でその地域にいた人が3000人しかいなかったという意味ではありません。
そこでサービスによっては、属性や地域ごとの偏り、携帯電話やアプリの利用状況などを考慮し、観測したサンプルから母集団全体の人数を推計します。図3では説明のため、3000人の観測サンプルから3万人という推計人口を算出する架空例を示しています。
ここで重要なのは、「人口・滞在人口」というデータ種別と、「観測サンプルか推計人口か」という違いは別の軸であることです。同じように「この地域には1万人いた」と表示されていても、一方は観測されたサンプル数、もう一方は母集団へ拡大推計された人数かもしれません。数字だけを横に並べても、同じ意味の数字を比較しているとは限らないわけです。
人流データの種類を整理すると
ここまでの内容を表にまとめると、次のようになります。
| データ種別 |
階層 |
主な単位 |
主に分かること |
商用サービスでの扱いの傾向 |
拡大推計 |
| 位置点 |
個票 |
ユーザー×時刻×位置 |
ある時刻にどこにいたか |
提供は限定的 |
集計時に適用する場合あり |
| 軌跡・移動区間 |
個票・加工 |
ユーザー×時系列位置 |
どう移動したか |
提供は限定的 |
集計時に適用する場合あり |
| 滞在・訪問イベント |
個票・加工 |
ユーザー×場所×時間 |
どこに滞在・来訪したか |
提供は限定的 |
集計時に適用する場合あり |
| 人口・滞在人口 |
集計 |
空間×時間×人数 |
その場所に何人いたか |
比較的一般的 |
あり/なし |
| 来訪者集計 |
集計 |
POI×期間×人数 |
施設への来訪状況 |
比較的一般的 |
あり/なし |
| OD |
集計 |
出発地×到着地×移動量 |
地域間の移動 |
比較的一般的 |
あり/なし |
この表はあくまで大まかな整理です。実際のサービスでは複数のデータ種別を組み合わせて提供する場合もありますし、元になる位置情報から独自の指標や属性を推定している場合もあります。また、どの粒度まで提供されるか、拡大推計を行うかどうかもサービスや用途によって異なります。
それでも、「人流データ」という言葉を見たときに、この表のどの段階に近いデータなのかを考えるだけで、そのデータで何ができるのかをかなり理解しやすくなります。
人流データを見るときに確認したいこと
人流データを比較するときには、いきなり「何人いるか」「サンプルが何万人あるか」と数字を見るよりも、その数字がどのように作られているかを先に確認した方がよさそうです。
まず、それがGPSや携帯電話ネットワークといった取得方式の話なのか、ODや滞在人口といったデータ種別の話なのかを区別します。そのうえで、個票なのか集計済みなのか、地域単位なのか施設単位なのか、人数は観測サンプルなのか拡大推計値なのか、と順番に確認していくとデータの性格が見えてきます。
たとえば「500mメッシュ単位で1時間ごとの滞在人口を提供するデータ」と「店舗単位で月間ユニーク来訪者数を提供するデータ」は、どちらも人流データですが、できる分析はかなり違います。同じOD形式でも、どのような元データから作られ、OriginとDestinationをどう定義し、どのように集計・推計したのかによって数字の意味は変わります。
つまり「人流データ」という名前だけで比較するのではなく、取得方式、加工段階、集計単位、人数の意味を確認することが重要です。
まとめ
「人流データ」という言葉の中には、位置点、軌跡・移動区間、滞在・訪問イベント、人口・滞在人口、来訪者集計、ODなど、異なる種類のデータが含まれています。
まず分けて考えたいのが、GPSや携帯電話ネットワークなどの取得方式と、ODや滞在人口などのデータ種別です。さらにデータ種別の中でも、ユーザーや端末を単位として扱う個票レベルと、地域や施設などの単位にまとめた集計レベルがあります。
そして集計された「人数」についても、それが実際に観測されたサンプルなのか、母集団へ拡大推計した人数なのかを確認する必要があります。同じ「1万人」という数字であっても、データが作られる過程が違えば、その意味は同じとは限りません。
つまり、人流データを見るときには、「どこの会社のデータなのか」だけではなく、何を観測し、それをどのような単位に加工・集計し、最終的にどんな数字として提供しているのかを見ることが重要です。
人流データを理解する第一歩は、「人流」という一種類のデータがあると考えるのではなく、位置情報が加工されていく過程で、目的の異なる複数のデータ種別が作られていると捉えることなのだと思います。
※本稿は筆者個人の調査・見解に基づくものであり、所属組織を代表するものではありません。